-
Preis: $0.08746 -1.7955%
-
Marktwert: 15.02B 0.5403%
-
Umsatz (24h): 976.34M 0%
-
Dominanz: 0.5403% 0.5403%
-
Preis: $0.08746 -1.7955%

Jede Zeile der Konfigurationsdatei dieses KI-Modells ist ein Papier
freigeben: 2026/08/19 08:00 lesen: 0
Ursprünglicher Autor:CloudAICode
Originalquelle:https://www.youtube.com/embed/KridVjxKMdo
#qwen #deepseek #flashattention Niemand kann mit der KI-Forschung mithalten, und die Leselisten, die Ihnen die Leute geben, werden danach geordnet, wie interessant eine Arbeit ist, und nicht danach, was sie Sie kostet. Öffnen Sie stattdessen die Konfigurationsdatei eines Frontier-Open-Modells und das Ranking schreibt sich von selbst: Jede Zeile darin ist ein Artikel, den jemand zuerst veröffentlichen musste, und nur wenige von ihnen entscheiden, ob Ihre Servicerechnung zahlbar ist. Dieses Video liest eine Konfigurationsdatei Zeile für Zeile und ordnet die elf Artikel dahinter nach dem, was sie Ihnen tatsächlich kaufen. Es beginnt mit einer 2,4 Billionen Parameterdatei, in der 512 Experten neben 10 Experten pro Token sitzen, also 95 Milliarden Parameter eingeschaltet sind und der Rest schläft, und führt diese Linie auf Shazeers spärlich begrenzte Expertenmischung aus dem Jahr 2017 und den behaupteten 1000-fachen Kapazitätsgewinn bei 137 Milliarden Parametern zurück. Dann FlashAttention, wo die Erkenntnis eher IO-Bewusstsein als bessere Mathematik war: 3x auf GPT-2 im ersten Artikel, 35 bis 75 Prozent Auslastung auf Hopper in Version 3, 1.613 Teraflops pro Sekunde und 71 Prozent eines B200 in Version 4, plus vier Veröffentlichungen in vier Wochen im Vergleich zu einem vier Jahre alten Artikel. Rotierende Einbettungen kommen als chinesischer Blogbeitrag von Jianlin Su vier Wochen vor RoFormer und erscheinen als Seil-Theta von 10 Millionen in Qwen, 8 Millionen in GLM und 10.000 mit einem Skalierungsblock in DeepSeek. Die Cache-Linie reicht von der Multi-Query-Aufmerksamkeit im Jahr 2019 über die gruppierte Abfrageaufmerksamkeit bei 64 Abfrageköpfen zu 4 Schlüsselwertköpfen, der ausgelagerten Aufmerksamkeit und dem 2- bis 4-fachen Durchsatz von vLLM bis hin zur latenten Aufmerksamkeit von DeepSeek, die 93,3 Prozent des Caches reduziert, einen 1.048.576-Token-Kontext, der aus 65.536 um den Faktor 16 berechnet wurde, und zwischengespeicherte Eingaben zu einem einunddreißigsten Preis. Die anderen sieben werden ebenfalls gelesen: Chain of Thought und das Audit der University of Texas, das Zuwächse von 14,2 Punkten bei symbolischen Aufgaben und 12,3 Punkten bei Mathematik ergab, aber sonst sehr wenig, ReAct und seine drei bekannten Fehlermodi, GraphRAG und die billigere Methode, die dieselben Autoren sieben Monate später auslieferten, MCP und A2A, CLIP und BLIP, und ein zwölfter Eintrag über erlernte Sparse-Indizierung, der in der Datei als Index Topk versteckt ist. Das Ranking richtet sich an jemanden, der für die Schlussfolgerung bezahlt, und es ist weniger wert, wenn Sie dies nicht tun. Behandeln Sie das Modell wie eine feste Ware mit Ihrem Hauptproblem in der Zeit zwischen den Anrufen und den Auftragsänderungen, wobei ReAct und der Abrufvorgang zuerst erfolgen und die Leistung vier einen Monat warten kann. Die FlashAttention 4-Nummern stammen ebenfalls aus Beta-Tags, hinter denen noch keine stabile Version steht. ⏱️ ZEITSTEMPEL: 00:00 – Öffnen der Konfigurationsdatei 00:21 – 512 Experten, 10 wach 00:37 – Das Sparsity-Papier 2017 01:45 – Flash-Aufmerksamkeit ist IO-bewusst 03:22 – Rotary-Einbettungen aus einem Blog-Beitrag 04:43 – Wohin das Serviergeld fließt 05:42 – Gruppierte Abfrage-Aufmerksamkeit 06:04 – Ausgelagerte Aufmerksamkeit und vLLM 06:31 – Latente Aufmerksamkeit reduziert sich um 93 Prozent 07:26 – Gedankenkette, geprüft 08:28 – ReAct und die Agentenschleife 09:12 – GraphRAG und seine günstigere Fortsetzung 10:54 – Das Ranking, ungesichert 12:20 – Papier zwölf und eine Wette 🔗 Die vier, die Miete zahlen: Outrageously Large Neural Networks (spärlich Gated Mix of Experts, 2017) https://arxiv.org/abs/1701.06538 FlashAttention (IO-bewusste genaue Aufmerksamkeit) https://arxiv.org/abs/2205.14135 Flash-attention (das Repository, das Sie anheften, nicht zitieren) https://github.com/Dao-AILab/flash-attention RoFormer (Rotationspositionseinbettung) https://arxiv.org/abs/2104.09864 Jianlin Sus Blog, in dem Rotary zum ersten Mal erschien https://kexue.fm Fast Transformer Decoding (Multi Query Attention, 2019) https://arxiv.org/abs/1911.02150 GQA (Grouped Query Attention) https://arxiv.org/abs/2305.13245 PagedAttention und vLLM https://arxiv.org/abs/2309.06180 vLLM (die Serving Engine) https://github.com/vllm-project/vllm DeepSeek-V2 (latente Aufmerksamkeit mit mehreren Köpfen) https://arxiv.org/abs/2405.04434 ⚡ Die anderen sieben und die zwölfte: • Chain-of-Thought Prompting https://arxiv.org/abs/2201.11903 • CoT oder nicht CoT (die Metaanalyse der University of Texas) • ReAct (Vernunft und Handlung) https://arxiv.org/abs/2210.03629 • GraphRAG (Microsoft Research) https://arxiv.org/abs/2404.16130 • LazyGraphRAG (der günstigere Nachfolger davon). Autoren) • Model Context Protocol https://modelcontextprotocol.io • A2A-Protokoll (Linux Foundation) • CLIP (Lernen übertragbarer visueller Modelle) https://arxiv.org/abs/2103.00020 • BLIP (Beschriftung, Filter, Bootstrap) https://arxiv.org/abs/2201.12086 #qwen #deepseek #flashattention #mixtureofexperts #kvcache #vllm #aipapers #llm #machinelearning 👇 ABONNIEREN & NÄCHSTES ANSCHAUEN Abonnieren Sie jede Woche für einen neuen Deep-Dive: https://www.youtube.com/@CloudAICode Benutzerabfragen: Welche Papiere sind in einer LLM-Konfigurationsdatei? Qwen-Konfigurationsdatei erklärt Expertenmischung erklärt, wie Flash Attention funktioniert, was KV-Cache in LLMs ist. Gruppierte Abfrageaufmerksamkeit vs. Mehrfachabfrage-Aufmerksamkeitsseil. Theta erklärte, wie ausgelagerte Aufmerksamkeit funktioniert Die Arbeit ist eine Gedankenkette, die immer noch nützlich ist und die besten KI-Artikel zum Lesen bietet
aktuelle Nachrichten
Mehr>>-
 CoinBaron
2026-09-21 04:54
-
 SHIBA INU CRYPTO
2026-09-21 04:54
-
 DADS DEFI SPACE
2026-09-21 04:54
-
 Roz Arai Ch.
2026-09-21 04:54
-
 Levi
2026-09-21 04:54
-
 Chan Wei Khjan
2026-09-21 04:35
-
 ICON TV - Polars
2026-09-21 04:35
-
 Kripto Detayı
2026-09-21 04:35
-
 PI News World
2026-09-21 02:35
Ausgewählte Themen
-
- Dogecoin-Wal-Aktivität
- Erhalten Sie mit unserer umfassenden Analyse die neuesten Erkenntnisse über die Aktivitäten der Dogecoin-Wale. Entdecken Sie Trends, Muster und die Auswirkungen dieser Wale auf den Dogecoin-Markt. Bleiben Sie mit unserer Expertenanalyse auf dem Laufenden und behalten Sie auf Ihrem Weg zur Kryptowährung die Nase vorn.
-
- Dogecoin-Mining
- Beim Dogecoin-Mining werden der Dogecoin-Blockchain neue Transaktionsblöcke hinzugefügt. Miner werden für ihre Arbeit mit neuen Dogecoins belohnt. Dieses Thema enthält Artikel zum Dogecoin-Mining, einschließlich der Anleitung zum Mining von Dogecoin, der besten Mining-Hardware und -Software und der Rentabilität des Dogecoin-Minings.
-
- Start des Spacex-Raumschiffs
- Dieses Thema enthält Artikel zu SpaceX-Raumschiffstarts, einschließlich Startdaten, Missionsdetails und Startstatus. Bleiben Sie mit dieser informativen und umfassenden Ressource über die neuesten Starts von SpaceX Starship auf dem Laufenden.
-
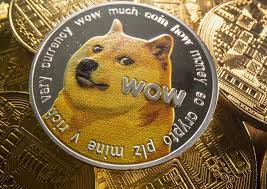
- König der Meme: Dogecoin
- Dieses Thema enthält Artikel zu den beliebtesten Memes, darunter „The King of Memes: Dogecoin“. Memecoin hat sich zu einem dominanten Akteur im Kryptoraum entwickelt. Diese digitalen Assets sind aus verschiedenen Gründen beliebt. Sie treiben die innovativsten Aspekte der Blockchain voran.
Ausgewählte Artikel
Mehr>>- 1 Arctic Pablo Coin (APC): Aufdeckung der Geheimnisse der Erde, einer Vorverkauf nach dem anderen
- 2 Neue Höhen für Dogecoin, Pepe und Shiba Inu im Jahr 2025, aber diese Krypto kann die Show mit 10.000% Gewinnen stehlen
- 3 Meme Coin Doge Uprising (DUP) könnte 100x, nachdem Präsident Donald Trump die Strategische Reserve von Crypto angekündigt hatte
- 4 Dogecoin (Doge) Preisvorhersage: Könnte Meme Coin bis Ende 2025 10 US -Dollar erreicht?
- 5 Cardanos Charles Hoskinson hat einige bemerkenswerte Bemerkungen zu Bitcoin und Dogecoin gemacht
- 6 Cloud Mining Craze: Bitcoin, Dogecoin und die Suche nach passivem Kryptoeinkommen
- 7 Grayscale, Dogecoin und das ETF-Debüt: Eine neue Ära für Meme-Coins?
- 8 Rexas Finance (RXS) könnte bis 2025 10x steigen und Pepe (Pepe) übertreffen
- 9 Bitcoin -Händler, der 30 Millionen US -Dollar für Doge verdiente
- 10 Dogecoin (DOGE) Preisvorhersage: Meme-Münze könnte sich auf 0,27 USD versammeln
Währung auswählen

US Dollar
USD

Chinese Yuan
CNY

Japanese Yen
JPY
South Korean Won
KRW

New Taiwan Dollar
TWD

Canadian Dollar
CAD

Euro
EUR

Pound Sterling
GBP

Danish Krone
DKK

Hong Kong Dollar
HKD

Australian Dollar
AUD

Brazilian Real
BRL

Swiss Franc
CHF

Chilean Peso
CLP

Czech Koruna KČ
CZK

Singapore Dollar
SGD
Indian Rupee
INR
Saudi Riyal
SAR
Vietnamese Dong
VND

Thai Baht
THB
Währung auswählen
-
US Dollar
USD-$

-
Chinese Yuan
CNY-¥
-
Japanese Yen
JPY-¥
-
South Korean Won
KRW -₩
-
New Taiwan Dollar
TWD-NT$
-
Canadian Dollar
CAD-$
-
Euro
EUR - €
-
Pound Sterling
GBP-£
-
Danish Krone
DKK-KR
-
Hong Kong Dollar
HKD- $
-
Australian Dollar
AUD-$
-
Brazilian Real
BRL -R$
-
Swiss Franc
CHF -FR
-
Chilean Peso
CLP-$
-
Czech Koruna KČ
CZK -KČ
-
Singapore Dollar
SGD-S$
-
Indian Rupee
INR -₹
-
Saudi Riyal
SAR -SAR
-
Vietnamese Dong
VND-₫
-
Thai Baht
THB -฿