-
Preis: $0.08739 -2.3081%
-
Marktwert: 13.63B 0.4901%
-
Umsatz (24h): 1.1B 0%
-
Dominanz: 0.4901% 0.4901%
-
Preis: $0.08739 -2.3081%

So konfigurieren Sie einen Elasticsearch-Tokenizer, um Großbuchstaben in separate Token aufzuteilen
freigeben: 2026/09/06 14:46 lesen: 0
Ursprünglicher Autor:vlogommentary
Originalquelle:https://www.youtube.com/embed/LxCCWuwkcpw
Erfahren Sie, wie Sie einen Elasticsearch-Tokenizer und -Analysator konfigurieren, um CamelCase- oder PascalCase-Wörter für eine verbesserte Suchübereinstimmung in separate Token aufzuteilen. --- Dieses Video basiert auf der Frage https://stackoverflow.com/q/79457368/ des Benutzers „dominikweber“ (https://stackoverflow.com/u/2849119/) und auf der Antwort https://stackoverflow.com/a/79457666/ des Benutzers „Paulo“ (https://stackoverflow.com/u/4534923/). „Stack Overflow“-Website. Vielen Dank an diese großartigen Benutzer und die Stackexchange-Community für ihre Beiträge. Besuchen Sie diese Links für Originalinhalte und weitere Details, wie alternative Lösungen, neueste Aktualisierungen/Entwicklungen zum Thema, Kommentare, Revisionsverlauf usw. Der ursprüngliche Titel der Frage lautete beispielsweise: Tokenizer, der Großbuchstaben in zwei Wörter aufteilt. Außerdem sind Inhalte (außer Musik) unter CC BY-SA https://meta.stackexchange.com/help/licensing lizenziert. Der ursprüngliche Fragebeitrag ist unter „CC BY-SA 4.0“ lizenziert ( https://creativecommons.org/licenses/by-sa/4.0/ )-Lizenz und der ursprüngliche Antwortbeitrag ist unter der „CC BY-SA 4.0“-Lizenz ( https://creativecommons.org/licenses/by-sa/4.0/ ) lizenziert. Wenn Ihnen etwas nicht stimmt, können Sie mir gerne einen Kommentar unter diesem Video hinterlassen. --- Einführung Wenn Sie Text wie „LoremIpsum“ in Elasticsearch indizieren und durchsuchen, möchten Sie dieses Wort „camelCase“ oder „PascalCase“ möglicherweise in mehrere Token aufteilen: „Lorem“, „Ipsum“ und auch das ursprüngliche „Loremipsum“-Token für eine breitere Übereinstimmung behalten. Dies verbessert die Suchflexibilität, indem Teilwörter oder das gesamte kombinierte Wort abgeglichen werden. Das Problem Standardmäßig teilt Elasticsearch nicht basierend auf Groß-/Kleinschreibungsänderungen in einzelnen Token auf. Daher führt die Suche nach „Lorem“ oder „Ipsum“ möglicherweise nicht zu den erwarteten Treffern, wenn der Text nur als ein Token „Loremipsum“ indiziert ist. Lösungsüberblick Wir können dieses Problem mithilfe eines benutzerdefinierten Analysers mit folgendem lösen: Schlüsselwort-Tokenizer (um die gesamte Eingabe anfänglich als ein einziges Token zu behandeln) Word_Delimiter-Tokenfilter, der so konfiguriert ist, dass er bei Änderungen der Groß-/Kleinschreibung aufgeteilt wird Kleinbuchstabenfilter zur Groß-/Kleinschreibung Der Schlüssel liegt in der Verwendung des Word_Delimiter-Filters mit: Split_on_Case_Change: True Preserve_Original: True (um das vollständige Token beizubehalten) Generate_word_parts: True Dieses Setup erzeugt alle erwarteten Token. Beispielkonfigurationsanalysator und -filter: [[Siehe Video, um diesen Text oder Codeausschnitt anzuzeigen]] Testen des Analysators: Sie können diesen Analysator mit der _analyze-API testen: [[Siehe Video, um diesen Text oder Codeausschnitt anzuzeigen]] Die Ausgabetokens lauten: loremipsum (ursprüngliches vollständiges Token) lorem (aufgeteilt bei Groß-/Kleinschreibungsänderung) ipsum (aufgeteilt bei Groß-/Kleinschreibungsänderung) Zuordnen Ihres Felds Um diesen Analysator zu verwenden, geben Sie ihn in Ihrer Indexzuordnung für den Text an Felder: [[Siehe Video, um diesen Text oder dieses Code-Snippet anzuzeigen]] Verwenden des Analysators in der Suche Standardmäßig verwenden Abfragen den im Mapping definierten Analysator. Sie können den Analysator jedoch während der Suche explizit angeben: [[Siehe Video, um diesen Text oder Codeausschnitt anzuzeigen]] Verwenden Sie diesen Ansatz, wenn Ihre Suchabfrage ein bestimmtes Tokenisierungsverhalten erfordert. Zusammenfassung Verwenden Sie einen Schlüsselwort-Tokenizer mit einem Word_Delimiter-Filter, um camelCase aufzuteilen. Legen Sie „preserve_original: true“ und „split_on_case_change: true“ für die gewünschten Token fest. Definieren Sie Ihre Textfelder mit diesem benutzerdefinierten Analysetool in Zuordnungen. Geben Sie optional den Analysator zur Suchzeit an, um die Konsistenz der Abfrage zu gewährleisten. Dieses Setup löst das häufige Problem der Indizierung und Suche nach CamelCase- oder PascalCase-Wörtern in Elasticsearch und liefert flexible und präzise Suchergebnisse.
aktuelle Nachrichten
Mehr>>-
 Ashes Club
2026-09-21 00:57
-
 Karauli Sarkar - Ishvariya Chikitsa Vigyan Kendra
2026-09-21 00:57
-
 Gold rate Telugu
2026-09-21 00:57
-
 CoinNexa VAULT.
2026-09-21 00:57
-
 Crypto Talk Now
2026-09-21 00:38
-
 Tieu Ai VN
2026-09-21 00:38
-
 Trade with Renato Ulianov
2026-09-21 00:38
-
 Professor Py: AI Engineering
2026-09-21 00:38
-
 Tech with Muthu
2026-09-21 00:38
Ausgewählte Themen
-
- Dogecoin-Wal-Aktivität
- Erhalten Sie mit unserer umfassenden Analyse die neuesten Erkenntnisse über die Aktivitäten der Dogecoin-Wale. Entdecken Sie Trends, Muster und die Auswirkungen dieser Wale auf den Dogecoin-Markt. Bleiben Sie mit unserer Expertenanalyse auf dem Laufenden und behalten Sie auf Ihrem Weg zur Kryptowährung die Nase vorn.
-
- Dogecoin-Mining
- Beim Dogecoin-Mining werden der Dogecoin-Blockchain neue Transaktionsblöcke hinzugefügt. Miner werden für ihre Arbeit mit neuen Dogecoins belohnt. Dieses Thema enthält Artikel zum Dogecoin-Mining, einschließlich der Anleitung zum Mining von Dogecoin, der besten Mining-Hardware und -Software und der Rentabilität des Dogecoin-Minings.
-
- Start des Spacex-Raumschiffs
- Dieses Thema enthält Artikel zu SpaceX-Raumschiffstarts, einschließlich Startdaten, Missionsdetails und Startstatus. Bleiben Sie mit dieser informativen und umfassenden Ressource über die neuesten Starts von SpaceX Starship auf dem Laufenden.
-
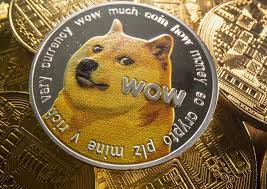
- König der Meme: Dogecoin
- Dieses Thema enthält Artikel zu den beliebtesten Memes, darunter „The King of Memes: Dogecoin“. Memecoin hat sich zu einem dominanten Akteur im Kryptoraum entwickelt. Diese digitalen Assets sind aus verschiedenen Gründen beliebt. Sie treiben die innovativsten Aspekte der Blockchain voran.
Ausgewählte Artikel
Mehr>>- 1 Arctic Pablo Coin (APC): Aufdeckung der Geheimnisse der Erde, einer Vorverkauf nach dem anderen
- 2 Neue Höhen für Dogecoin, Pepe und Shiba Inu im Jahr 2025, aber diese Krypto kann die Show mit 10.000% Gewinnen stehlen
- 3 Meme Coin Doge Uprising (DUP) könnte 100x, nachdem Präsident Donald Trump die Strategische Reserve von Crypto angekündigt hatte
- 4 Dogecoin (Doge) Preisvorhersage: Könnte Meme Coin bis Ende 2025 10 US -Dollar erreicht?
- 5 Cardanos Charles Hoskinson hat einige bemerkenswerte Bemerkungen zu Bitcoin und Dogecoin gemacht
- 6 Cloud Mining Craze: Bitcoin, Dogecoin und die Suche nach passivem Kryptoeinkommen
- 7 Grayscale, Dogecoin und das ETF-Debüt: Eine neue Ära für Meme-Coins?
- 8 Rexas Finance (RXS) könnte bis 2025 10x steigen und Pepe (Pepe) übertreffen
- 9 Bitcoin -Händler, der 30 Millionen US -Dollar für Doge verdiente
- 10 Dogecoin (DOGE) Preisvorhersage: Meme-Münze könnte sich auf 0,27 USD versammeln
Währung auswählen

US Dollar
USD

Chinese Yuan
CNY

Japanese Yen
JPY
South Korean Won
KRW

New Taiwan Dollar
TWD

Canadian Dollar
CAD

Euro
EUR

Pound Sterling
GBP

Danish Krone
DKK

Hong Kong Dollar
HKD

Australian Dollar
AUD

Brazilian Real
BRL

Swiss Franc
CHF

Chilean Peso
CLP

Czech Koruna KČ
CZK

Singapore Dollar
SGD
Indian Rupee
INR
Saudi Riyal
SAR
Vietnamese Dong
VND

Thai Baht
THB
Währung auswählen
-
US Dollar
USD-$

-
Chinese Yuan
CNY-¥
-
Japanese Yen
JPY-¥
-
South Korean Won
KRW -₩
-
New Taiwan Dollar
TWD-NT$
-
Canadian Dollar
CAD-$
-
Euro
EUR - €
-
Pound Sterling
GBP-£
-
Danish Krone
DKK-KR
-
Hong Kong Dollar
HKD- $
-
Australian Dollar
AUD-$
-
Brazilian Real
BRL -R$
-
Swiss Franc
CHF -FR
-
Chilean Peso
CLP-$
-
Czech Koruna KČ
CZK -KČ
-
Singapore Dollar
SGD-S$
-
Indian Rupee
INR -₹
-
Saudi Riyal
SAR -SAR
-
Vietnamese Dong
VND-₫
-
Thai Baht
THB -฿