-
Preis: $0.05514 -0.6417%
-
Marktwert: 8.65B 0.4161%
-
Umsatz (24h): 419.17M 0%
-
Dominanz: 0.4161% 0.4161%
-
Preis: $0.05514 -0.6417%

Jemand hat LoRA auf Qwen 3.8 installiert und das 4,5-fache an Token gespart. Verbrennen Sie immer noch Rechenleistung?
freigeben: 2026/11/19 01:04 lesen: 0
Ursprünglicher Autor:智用AI
Originalquelle:https://www.youtube.com/embed/hs2BpFPKuqA
Der Qwen3.8-27B LoRA-Adapter von Hugging Face Harness-Hub erreicht die Genauigkeit des Basismodells, wenn der Denkmodus ausgeschaltet ist, und der Token-Verbrauch wird um etwa das 4,5-fache reduziert. Das Harness-Hub-Team von Hugging Face hat den LoRA-Adapter Qwen3.8-27B-pi-adaptiert für Qwen3.8-27B veröffentlicht, der speziell für Pi-Codierungsagenten verwendet wird. Der Adapter wird durch Reinforcement-Learning-Methoden trainiert und verbessert die Pass@1-Genauigkeit von 39,2 % auf 64,7 % auf SWE-Bench Pro und von 39,5 % auf 55,8 % auf Terminal-Bench 2.1. Noch wichtiger ist, dass es bei ausgeschaltetem Denkmodus das Genauigkeitsniveau des Basismodells erreicht, wenn der Denkmodus ausgeschaltet ist. Gleichzeitig wird der Token-Verbrauch um etwa das 4,5-fache reduziert und die Anzahl der Interaktionsrunden deutlich verkürzt. In diesem Artikel werden der Trainingsmechanismus für verstärktes Lernen, die Bewertungsleistung und der Bereitstellungspfad des LoRA-Adapters erläutert. Qwen3.8-27B, LoRA, Coding Agent, Reinforcement Learning, Pi, SWE-Bench, vLLM. Wenn diese Art der zugrunde liegenden Demontage für Sie nützlich ist, abonnieren Sie es und öffnen Sie die kleine Glocke. Das neue Update wird Ihnen so schnell wie möglich zugestellt. ⏱ Kapitel 00:00 Das kontraintuitive Ergebnis wird zuerst angezeigt: Schalten Sie den Denkmodus aus, die Genauigkeitsrate steigt statt zu sinken und die Anzahl der Interaktionsrunden wird stark verkürzt. 00:46 Es handelt sich nicht um eine allgemeine Feinabstimmung, sondern um einen Reinforcement-Learning-Adapter, der auf die spezifische Agentenumgebung von Pi zugeschnitten ist. 01:14 Der Trainingsumfang ist nicht groß: 750 Scale800-Aufgaben plus 300 TermG 01:26 Der Adapter ist stark an den Pi gebunden und garantiert keine Migration zu anderen Agent-Frameworks; Gleichzeitig sind die Basisarchitektur und das Kontextfenster schwierig. 02:23 Ein Urteil, das es wert ist, mitgenommen zu werden: Die Durchführung einer kleinen LoRA-Learning-Learning-Ausrichtung für eine bestimmte Agentenumgebung verbessert die lokale Programmierung. 🔎 Auswahl aus diesem Video fortsetzen: https://zhiyong.dev/y/hs2BpFPKuqA --- 🔎 Verwandte KI-Tools, Modelle und Anwendungen: https://zhiyong.dev
aktuelle Nachrichten
Mehr>>-
 CRYPTO_BEN
2026-11-22 23:36
-
 子敬.轮回珠宝
2026-11-22 23:36
-
 kumis patiler
2026-11-22 23:36
-
 Ha Ms
2026-11-22 23:36
-
 CryptoMetric
2026-11-22 23:36
-
 劇翻天 Drama Go
2026-11-22 16:36
-
 CryptoMason
2026-11-22 16:22
-
 Lý Tử Ly
2026-11-22 14:42
-
 Pidoku
2026-11-22 14:15
Ausgewählte Themen
-
- Dogecoin-Wal-Aktivität
- Erhalten Sie mit unserer umfassenden Analyse die neuesten Erkenntnisse über die Aktivitäten der Dogecoin-Wale. Entdecken Sie Trends, Muster und die Auswirkungen dieser Wale auf den Dogecoin-Markt. Bleiben Sie mit unserer Expertenanalyse auf dem Laufenden und behalten Sie auf Ihrem Weg zur Kryptowährung die Nase vorn.
-
- Dogecoin-Mining
- Beim Dogecoin-Mining werden der Dogecoin-Blockchain neue Transaktionsblöcke hinzugefügt. Miner werden für ihre Arbeit mit neuen Dogecoins belohnt. Dieses Thema enthält Artikel zum Dogecoin-Mining, einschließlich der Anleitung zum Mining von Dogecoin, der besten Mining-Hardware und -Software und der Rentabilität des Dogecoin-Minings.
-
- Start des Spacex-Raumschiffs
- Dieses Thema enthält Artikel zu SpaceX-Raumschiffstarts, einschließlich Startdaten, Missionsdetails und Startstatus. Bleiben Sie mit dieser informativen und umfassenden Ressource über die neuesten Starts von SpaceX Starship auf dem Laufenden.
-
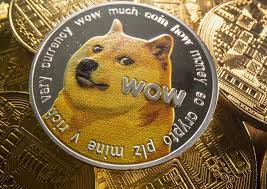
- König der Meme: Dogecoin
- Dieses Thema enthält Artikel zu den beliebtesten Memes, darunter „The King of Memes: Dogecoin“. Memecoin hat sich zu einem dominanten Akteur im Kryptoraum entwickelt. Diese digitalen Assets sind aus verschiedenen Gründen beliebt. Sie treiben die innovativsten Aspekte der Blockchain voran.
Ausgewählte Artikel
Mehr>>- 1 Arctic Pablo Coin (APC): Aufdeckung der Geheimnisse der Erde, einer Vorverkauf nach dem anderen
- 2 Neue Höhen für Dogecoin, Pepe und Shiba Inu im Jahr 2025, aber diese Krypto kann die Show mit 10.000% Gewinnen stehlen
- 3 Meme Coin Doge Uprising (DUP) könnte 100x, nachdem Präsident Donald Trump die Strategische Reserve von Crypto angekündigt hatte
- 4 Dogecoin (Doge) Preisvorhersage: Könnte Meme Coin bis Ende 2025 10 US -Dollar erreicht?
- 5 Cardanos Charles Hoskinson hat einige bemerkenswerte Bemerkungen zu Bitcoin und Dogecoin gemacht
- 6 Cloud Mining Craze: Bitcoin, Dogecoin und die Suche nach passivem Kryptoeinkommen
- 7 Grayscale, Dogecoin und das ETF-Debüt: Eine neue Ära für Meme-Coins?
- 8 Rexas Finance (RXS) könnte bis 2025 10x steigen und Pepe (Pepe) übertreffen
- 9 Bitcoin -Händler, der 30 Millionen US -Dollar für Doge verdiente
- 10 Dogecoin (DOGE) Preisvorhersage: Meme-Münze könnte sich auf 0,27 USD versammeln
Währung auswählen

US Dollar
USD

Chinese Yuan
CNY

Japanese Yen
JPY
South Korean Won
KRW

New Taiwan Dollar
TWD

Canadian Dollar
CAD

Euro
EUR

Pound Sterling
GBP

Danish Krone
DKK

Hong Kong Dollar
HKD

Australian Dollar
AUD

Brazilian Real
BRL

Swiss Franc
CHF

Chilean Peso
CLP

Czech Koruna KČ
CZK

Singapore Dollar
SGD
Indian Rupee
INR
Saudi Riyal
SAR
Vietnamese Dong
VND

Thai Baht
THB
Währung auswählen
-
US Dollar
USD-$

-
Chinese Yuan
CNY-¥
-
Japanese Yen
JPY-¥
-
South Korean Won
KRW -₩
-
New Taiwan Dollar
TWD-NT$
-
Canadian Dollar
CAD-$
-
Euro
EUR - €
-
Pound Sterling
GBP-£
-
Danish Krone
DKK-KR
-
Hong Kong Dollar
HKD- $
-
Australian Dollar
AUD-$
-
Brazilian Real
BRL -R$
-
Swiss Franc
CHF -FR
-
Chilean Peso
CLP-$
-
Czech Koruna KČ
CZK -KČ
-
Singapore Dollar
SGD-S$
-
Indian Rupee
INR -₹
-
Saudi Riyal
SAR -SAR
-
Vietnamese Dong
VND-₫
-
Thai Baht
THB -฿