-
prix: $0.05526 0.295%
-
Valeur marchande: 8.67B 0.417%
-
Chiffre d’affaires (24h): 407.79M 0%
-
Dominance: 0.417% 0.417%
-
prix: $0.05526 0.295%

Que se passe-t-il à l'intérieur d'une puce IA lorsque vous posez une question
libérer: 2026/11/17 12:09 lire: 0
Auteur original:Ohmhytte
Source originale:https://www.youtube.com/embed/HePsdhmLf_A
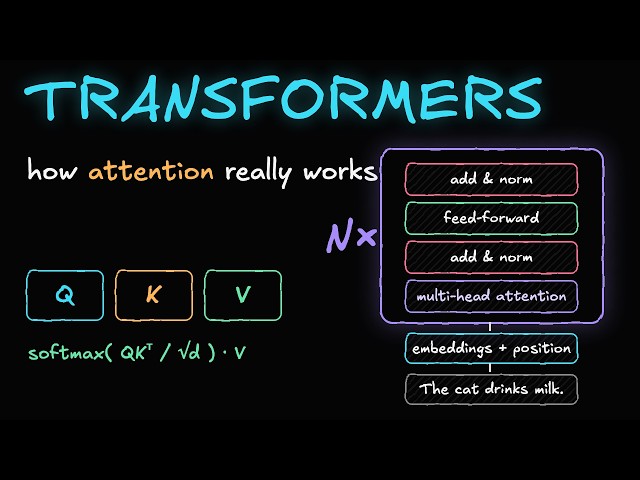
Une puce d’IA moderne peut effectuer environ mille milliards de calculs par seconde. Posez-lui une question, et la réponse arrive toujours fragment de mot à la fois, tandis que la partie de la puce qui effectue l'arithmétique passe la plupart de son temps à attendre. En attendant quoi ? Nous suivons une question « Pourquoi le ciel est-il bleu ? » à travers la puce. Le texte devient des jetons puis des nombres entiers ; chaque nombre devient une liste de milliers de nombres ; et chaque couche du modèle est principalement une multiplication matricielle, découpée en tuiles et partagée entre les cœurs tenseurs de la puce. La question est lue en une seule fois. La réponse ne peut être écrite qu'un jeton à la fois, et chaque nouveau jeton nécessite que presque tous les poids du modèle soient à nouveau lus dans la mémoire : pour un modèle avec huit milliards de poids de 16 bits, environ 15 Go par jeton. Aux 3,35 téraoctets par seconde du H100 de NVIDIA, cela prend environ 4,5 millièmes de seconde, alors que l'arithmétique elle-même prendrait environ 15 millionièmes. Ajoutez le cache KV, les clés et les valeurs conservées pour chaque jeton précédent, et vous comprendrez pourquoi les puces IA sont construites autour de la mémoire, et pourquoi les centres de données regroupent de nombreuses conversations en une seule lecture, stockent les poids en moins de bits et divisent les grands modèles sur plusieurs puces. Les identifiants des jetons et les probabilités du prochain jeton affichés sont réels : ils proviennent d'un petit modèle à poids ouvert posé la même question pour ce film. Les chiffres du H100 correspondent aux spécifications maximales publiées par NVIDIA. La puce à l'écran est un accélérateur générique et stylisé dessiné pour ce film, et non une véritable disposition de puce ; les timings sont un décompte idéalisé (taux de pointe, pas de frais généraux), donc les systèmes réels sont plus lents ; et le modèle pesant 8 milliards a la forme publiée du Lama 3 8B de Meta. Chapitres 0:00 Une question, sous forme de nombres 1:15 Listes de nombres 2:15 Arithmétique en tuiles 3:34 Le mur de mémoire 5:06 Un jeton, une couche, un choix 6:31 Plus de personnes, moins de bits, plus de puces 8:01 La réponse, une pièce à la fois Sources - Blog technique NVIDIA, "NVIDIA Hopper Architecture In-Depth" (2022) : https://developer.nvidia.com/blog/nvidia-hopper-architecture-in-owned/ - NVIDIA, spécifications du GPU H100 Tensor Core : https://www.nvidia.com/en-us/data-center/h100/ - Blog technique NVIDIA, « NVIDIA Ampere Architecture In-Depth » (2020) : https://developer.nvidia.com/blog/nvidia-ampere-architecture-in-owned/ - Blog technique NVIDIA, « Inférence accélérée pour les grands modèles de transformateurs utilisant le serveur d'inférence NVIDIA Triton et FasterTransformer » : https://developer.nvidia.com/blog/accelerated-inference-for-large-transformer-models-using-nvidia-fastertransformer-and-nvidia-triton-inference-server/ - Blog technique NVIDIA, « Maîtriser les techniques LLM : optimisation de l'inférence » : https://developer.nvidia.com/blog/mastering-llm-techniques-inference-optimization/ - NVIDIA Deep Learning Performance Guide, "Matrix Multiplication Background" : https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html - A. Vaswani et al., "L'attention est tout ce dont vous avez besoin", NeurIPS 2017 : https://arxiv.org/abs/1706.03762 - R. Sennrich, B. Haddow, A. Birch, "Traduction automatique neuronale de mots rares avec des unités de sous-mots", ACL 2016 : https://arxiv.org/abs/1508.07909 - J. Kaplan et al., "Mise à l'échelle des lois pour les modèles de langage neuronal" (2020) : https://arxiv.org/abs/2001.08361 - R. Pope et al., "Efficiently Scaling Transformer Inference", MLSys 2023 : https://arxiv.org/abs/2211.05102 - W. Kwon et al., "Gestion efficace de la mémoire pour le service de modèles de langage étendus avec PagedAttention", SOSP 2023 : https://arxiv.org/abs/2309.06180 - J. Ainslie et al., "GQA : Formation de modèles de transformateurs multi-requêtes généralisés à partir de points de contrôle multi-têtes", EMNLP 2023 : https://arxiv.org/abs/2305.13245 - Llama Team, AI @ Meta, "The Llama 3 Herd of Models" (2024) : https://arxiv.org/abs/2407.21783 - T. Dettmers et al., "LLM.int8() : Multiplication matricielle 8 bits pour les transformateurs à l'échelle", NeurIPS 2022 : https://arxiv.org/abs/2208.07339 - E. Frantar et al., "GPTQ : Quantification précise post-entraînement pour les transformateurs pré-entraînés génératifs", ICLR 2023 : https://arxiv.org/abs/2210.17323 - J. Lin et al., "AWQ : Activation-aware Weight Quantization for LLM Compression and Acceleration", MLSys 2024 : https://arxiv.org/abs/2306.00978 - SK hynix Newsroom, "SK hynix développe le premier 12 couches de l'industrie HBM3" : https://news.skhynix.com/sk-hynix-develops-industrys-first-12-layer-hbm3/ Musique et effets sonores : originaux, réalisés pour ce film. Polices : Source Sans 3 (Adobe) et Figtree (Erik Kennedy), SIL Open Font License 1.1. #IA #Technologie #Science #Ingénierie #Informatique
nouvelles récentes
Plus>>-
 子敬.轮回珠宝
2026-11-22 23:55
-
 kumis patiler
2026-11-22 23:55
-
 Ha Ms
2026-11-22 23:55
-
 CRYPTO_BEN
2026-11-22 23:55
-
 CryptoMetric
2026-11-22 23:55
-
 劇翻天 Drama Go
2026-11-22 16:36
-
 CryptoMason
2026-11-22 16:22
-
 Lý Tử Ly
2026-11-22 14:42
-
 Pidoku
2026-11-22 14:15
Sujets en vedette
-
- Activité des baleines Dogecoin
- Obtenez les dernières informations sur les activités des baleines Dogecoin grâce à notre analyse complète. Découvrez les tendances, les modèles et l'impact de ces baleines sur le marché Dogecoin. Restez informé grâce à notre analyse d’experts et gardez une longueur d’avance dans votre parcours de crypto-monnaie.
-
- Extraction de Dogecoins
- Le minage de Dogecoin est le processus d'ajout de nouveaux blocs de transactions à la blockchain Dogecoin. Les mineurs sont récompensés par un nouveau Dogecoin pour leur travail. Cette rubrique propose des articles liés au minage de Dogecoin, notamment sur la manière d'exploiter du Dogecoin, les meilleurs matériels et logiciels de minage et la rentabilité du minage de Dogecoin.
-
- Lancement du vaisseau Spacex
- Cette rubrique fournit des articles relatifs aux lancements de SpaceX Starship, notamment les dates de lancement, les détails de la mission et l'état du lancement. Restez au courant des derniers lancements de SpaceX Starship avec cette ressource informative et complète.
-
- Roi des mèmes : Dogecoin
- Cette rubrique propose des articles liés aux mèmes les plus populaires, notamment « Le roi des mèmes : Dogecoin ». Memecoin est devenu un acteur dominant dans l’espace crypto. Ces actifs numériques sont populaires pour diverses raisons. Ils pilotent les aspects les plus innovants de la blockchain.
Articles en vedette
Plus>>- 1 Arctic Pablo Coin (APC): Découvrir les mystères de la Terre, une prévente à la fois
- 2 Nouveaux sommets pour Dogecoin, Pepe et Shiba Inu en 2025, mais cette crypto pourrait voler le spectacle avec 10 000% de gains
- 3 Meme Coin Doge Uprising (DUP) pourrait 100 fois après que le président Donald Trump annonce la réserve stratégique de crypto
- 4 Prédiction de prix de Dogecoin (DOGE): Meme Coin a-t-elle atteint 10 $ d'ici la fin de 2025?
- 5 Charles Hoskinson de Cardano a fait des remarques notables sur Bitcoin et Dogecoin
- 6 Cloud Mining Craze: Bitcoin, Dogecoin et la quête du revenu cryptographique passif
- 7 Grayscale, Dogecoin et les débuts de l'ETF : une nouvelle ère pour les Meme Coins ?
- 8 Rexas Finance (RXS) pourrait augmenter 10x d'ici 2025, dépassant Pepe (Pepe)
- 9 Bitcoin Trader qui a fait 30 millions de dollars sur DOGE prévoit une augmentation de 6 000% pour ce jeton AI de 0,0000002 $ - Obtenez des jetons bonus de 80%
- 10 Prédiction de prix de Dogecoin (DOGE): la pièce de mème pourrait se rassembler à 0,27 $ car elle se ferme au-dessus
Sélectionnez la devise

US Dollar
USD

Chinese Yuan
CNY

Japanese Yen
JPY
South Korean Won
KRW

New Taiwan Dollar
TWD

Canadian Dollar
CAD

Euro
EUR

Pound Sterling
GBP

Danish Krone
DKK

Hong Kong Dollar
HKD

Australian Dollar
AUD

Brazilian Real
BRL

Swiss Franc
CHF

Chilean Peso
CLP

Czech Koruna KČ
CZK

Singapore Dollar
SGD
Indian Rupee
INR
Saudi Riyal
SAR
Vietnamese Dong
VND

Thai Baht
THB
Sélectionnez la devise
-
US Dollar
USD-$

-
Chinese Yuan
CNY-¥
-
Japanese Yen
JPY-¥
-
South Korean Won
KRW -₩
-
New Taiwan Dollar
TWD-NT$
-
Canadian Dollar
CAD-$
-
Euro
EUR - €
-
Pound Sterling
GBP-£
-
Danish Krone
DKK-KR
-
Hong Kong Dollar
HKD- $
-
Australian Dollar
AUD-$
-
Brazilian Real
BRL -R$
-
Swiss Franc
CHF -FR
-
Chilean Peso
CLP-$
-
Czech Koruna KČ
CZK -KČ
-
Singapore Dollar
SGD-S$
-
Indian Rupee
INR -₹
-
Saudi Riyal
SAR -SAR
-
Vietnamese Dong
VND-₫
-
Thai Baht
THB -฿