-
Preis: $0.05526 0.295%
-
Marktwert: 8.67B 0.417%
-
Umsatz (24h): 407.79M 0%
-
Dominanz: 0.417% 0.417%
-
Preis: $0.05526 0.295%

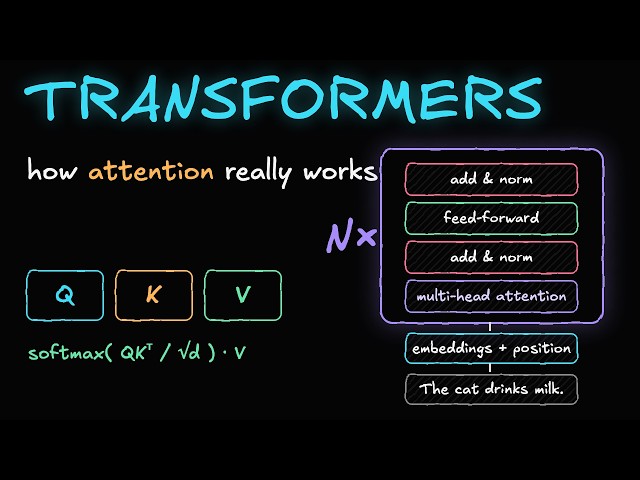
Was passiert in einem KI-Chip, wenn Sie eine Frage stellen?
freigeben: 2026/11/17 12:09 lesen: 0
Ursprünglicher Autor:Ohmhytte
Originalquelle:https://www.youtube.com/embed/HePsdhmLf_A
Ein moderner KI-Chip kann etwa tausend Billionen Berechnungen pro Sekunde durchführen. Stellen Sie ihm eine Frage, und die Antwort kommt immer noch Wortfragment nach dem anderen, während der Teil des Chips, der die Arithmetik durchführt, die meiste Zeit damit verbringt, zu warten. Worauf warten? Einer Frage, „Warum ist der Himmel blau?“, gehen wir durch den Chip nach. Der Text wird zu Token und dann zu ganzen Zahlen; jede Zahl wird zu einer Liste von Tausenden von Zahlen; und jede Schicht des Modells besteht größtenteils aus Matrixmultiplikation, die in Kacheln zerschnitten und auf die Tensorkerne des Chips verteilt wird. Die Frage wird auf einmal gelesen. Die Antwort kann jeweils nur in einem Token geschrieben werden, und für jeden neuen Token müssen nahezu alle Gewichtungen des Modells erneut aus dem Speicher gelesen werden: bei einem Modell mit acht Milliarden 16-Bit-Gewichten etwa 15 GB pro Token. Bei den 3,35 Terabyte pro Sekunde von NVIDIAs H100 dauert das etwa 4,5 Tausendstelsekunden, während die Berechnung selbst etwa 15 Millionstelsekunden dauern würde. Fügen Sie den KV-Cache hinzu, die Schlüssel und Werte, die für jedes frühere Token aufbewahrt werden, und Sie sehen, warum KI-Chips rund um den Speicher aufgebaut sind und warum Rechenzentren viele Konversationen in einem Lesevorgang zusammenfassen, Gewichte in weniger Bits speichern und große Modelle auf mehrere Chips aufteilen. Die angezeigten Token-IDs und Next-Token-Wahrscheinlichkeiten sind real: Sie stammen von einem kleinen Modell mit offenem Gewicht, dem für diesen Film dieselbe Frage gestellt wurde. Bei den H100-Zahlen handelt es sich um die von NVIDIA veröffentlichten Spitzenspezifikationen. Der Chip auf dem Bildschirm ist ein allgemeiner, stilisierter Beschleuniger, der für diesen Film gezeichnet wurde, nicht das Layout eines echten Chips; Bei den Timings handelt es sich um eine idealisierte Zählung (Spitzenraten, kein Overhead), sodass reale Systeme langsamer sind. und das 8-Milliarden-schwere Modell hat die veröffentlichte Form von Metas Llama 3 8B. Kapitel 0:00 Eine Frage, als Zahlen 1:15 Zahlenlisten 2:15 Arithmetik in Kacheln 3:34 Die Speicherwand 5:06 Ein Token, eine Schicht, eine Wahl 6:31 Mehr Menschen, weniger Bits, mehr Chips 8:01 Die Antwort, Stück für Stück Quellen – NVIDIA Technical Blog, „NVIDIA Hopper Architecture In-Depth“ (2022): https://developer.nvidia.com/blog/nvidia-hopper-architecture-in- Depth/ – NVIDIA, H100 Tensor Core GPU-Spezifikationen: https://www.nvidia.com/en-us/data-center/h100/ – NVIDIA Technical Blog, „NVIDIA Ampere Architecture In-Depth“ (2020): https://developer.nvidia.com/blog/nvidia-ampere-architecture-in-third/ – Technischer Blog von NVIDIA, „Beschleunigte Inferenz für große Transformer-Modelle mit NVIDIA Triton Inference Server und FasterTransformer“: https://developer.nvidia.com/blog/accelerated-inference-for-large-transformer-models-using-nvidia-fastertransformer-and-nvidia-triton-inference-server/ – NVIDIA Technical Blog, „Mastering LLM Techniques: Inference Optimization“: https://developer.nvidia.com/blog/mastering-llm-techniques-inference-optimization/ – NVIDIA Deep Learning Performance Leitfaden, „Hintergrund der Matrixmultiplikation“: https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html – A. Vaswani et al., „Attention Is All You Need“, NeurIPS 2017: https://arxiv.org/abs/1706.03762 – R. Sennrich, B. Haddow, A. Birch, „Neural Machine Translation of Rare Words with Subword Units“, ACL 2016: https://arxiv.org/abs/1508.07909 – J. Kaplan et al., „Scaling Laws for Neural Language Models“ (2020): https://arxiv.org/abs/2001.08361 – R. Pope et al., „Efficiently Scaling Transformer Inference“, MLSys 2023: https://arxiv.org/abs/2211.05102 – W. Kwon et al., „Efficient Memory Management for Large Language Model Serving with PagedAttention“, SOSP 2023: https://arxiv.org/abs/2309.06180 – J. Ainslie et al., „GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints“, EMNLP 2023: https://arxiv.org/abs/2305.13245 – Llama Team, AI @ Meta, „The Llama 3 Herd of Models“ (2024): https://arxiv.org/abs/2407.21783 – T. Dettmers et al., „LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale“, NeurIPS 2022: https://arxiv.org/abs/2208.07339 – E. Frantar et al., „GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers“, ICLR 2023: https://arxiv.org/abs/2210.17323 – J. Lin et al., „AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration“, MLSys 2024: https://arxiv.org/abs/2306.00978 – SK hynix Newsroom, „SK hynix Develops Industry’s First 12-Layer HBM3“: https://news.skhynix.com/sk-hynix-develops-industrys-first-12-layer-hbm3/ Musik und Soundeffekte: Original, für diesen Film gemacht. Schriftarten: Source Sans 3 (Adobe) und Figtree (Erik Kennedy), SIL Open Font License 1.1. #KI #Technologie #Wissenschaft #Ingenieurwesen #Computing
aktuelle Nachrichten
Mehr>>-
 子敬.轮回珠宝
2026-11-22 23:55
-
 kumis patiler
2026-11-22 23:55
-
 Ha Ms
2026-11-22 23:55
-
 CRYPTO_BEN
2026-11-22 23:55
-
 CryptoMetric
2026-11-22 23:55
-
 劇翻天 Drama Go
2026-11-22 16:36
-
 CryptoMason
2026-11-22 16:22
-
 Lý Tử Ly
2026-11-22 14:42
-
 Pidoku
2026-11-22 14:15
Ausgewählte Themen
-
- Dogecoin-Wal-Aktivität
- Erhalten Sie mit unserer umfassenden Analyse die neuesten Erkenntnisse über die Aktivitäten der Dogecoin-Wale. Entdecken Sie Trends, Muster und die Auswirkungen dieser Wale auf den Dogecoin-Markt. Bleiben Sie mit unserer Expertenanalyse auf dem Laufenden und behalten Sie auf Ihrem Weg zur Kryptowährung die Nase vorn.
-
- Dogecoin-Mining
- Beim Dogecoin-Mining werden der Dogecoin-Blockchain neue Transaktionsblöcke hinzugefügt. Miner werden für ihre Arbeit mit neuen Dogecoins belohnt. Dieses Thema enthält Artikel zum Dogecoin-Mining, einschließlich der Anleitung zum Mining von Dogecoin, der besten Mining-Hardware und -Software und der Rentabilität des Dogecoin-Minings.
-
- Start des Spacex-Raumschiffs
- Dieses Thema enthält Artikel zu SpaceX-Raumschiffstarts, einschließlich Startdaten, Missionsdetails und Startstatus. Bleiben Sie mit dieser informativen und umfassenden Ressource über die neuesten Starts von SpaceX Starship auf dem Laufenden.
-
- König der Meme: Dogecoin
- Dieses Thema enthält Artikel zu den beliebtesten Memes, darunter „The King of Memes: Dogecoin“. Memecoin hat sich zu einem dominanten Akteur im Kryptoraum entwickelt. Diese digitalen Assets sind aus verschiedenen Gründen beliebt. Sie treiben die innovativsten Aspekte der Blockchain voran.
Ausgewählte Artikel
Mehr>>- 1 Arctic Pablo Coin (APC): Aufdeckung der Geheimnisse der Erde, einer Vorverkauf nach dem anderen
- 2 Neue Höhen für Dogecoin, Pepe und Shiba Inu im Jahr 2025, aber diese Krypto kann die Show mit 10.000% Gewinnen stehlen
- 3 Meme Coin Doge Uprising (DUP) könnte 100x, nachdem Präsident Donald Trump die Strategische Reserve von Crypto angekündigt hatte
- 4 Dogecoin (Doge) Preisvorhersage: Könnte Meme Coin bis Ende 2025 10 US -Dollar erreicht?
- 5 Cardanos Charles Hoskinson hat einige bemerkenswerte Bemerkungen zu Bitcoin und Dogecoin gemacht
- 6 Cloud Mining Craze: Bitcoin, Dogecoin und die Suche nach passivem Kryptoeinkommen
- 7 Grayscale, Dogecoin und das ETF-Debüt: Eine neue Ära für Meme-Coins?
- 8 Rexas Finance (RXS) könnte bis 2025 10x steigen und Pepe (Pepe) übertreffen
- 9 Bitcoin -Händler, der 30 Millionen US -Dollar für Doge verdiente
- 10 Dogecoin (DOGE) Preisvorhersage: Meme-Münze könnte sich auf 0,27 USD versammeln
Währung auswählen

US Dollar
USD

Chinese Yuan
CNY

Japanese Yen
JPY
South Korean Won
KRW

New Taiwan Dollar
TWD

Canadian Dollar
CAD

Euro
EUR

Pound Sterling
GBP

Danish Krone
DKK

Hong Kong Dollar
HKD

Australian Dollar
AUD

Brazilian Real
BRL

Swiss Franc
CHF

Chilean Peso
CLP

Czech Koruna KČ
CZK

Singapore Dollar
SGD
Indian Rupee
INR
Saudi Riyal
SAR
Vietnamese Dong
VND

Thai Baht
THB
Währung auswählen
-
US Dollar
USD-$

-
Chinese Yuan
CNY-¥
-
Japanese Yen
JPY-¥
-
South Korean Won
KRW -₩
-
New Taiwan Dollar
TWD-NT$
-
Canadian Dollar
CAD-$
-
Euro
EUR - €
-
Pound Sterling
GBP-£
-
Danish Krone
DKK-KR
-
Hong Kong Dollar
HKD- $
-
Australian Dollar
AUD-$
-
Brazilian Real
BRL -R$
-
Swiss Franc
CHF -FR
-
Chilean Peso
CLP-$
-
Czech Koruna KČ
CZK -KČ
-
Singapore Dollar
SGD-S$
-
Indian Rupee
INR -₹
-
Saudi Riyal
SAR -SAR
-
Vietnamese Dong
VND-₫
-
Thai Baht
THB -฿