-
價格: $0.05506 0.0571%
-
市值: 8.64B 0.4153%
-
成交額 (24h): 390.6M 0%
-
統治力: 0.4153% 0.4153%
-
價格: $0.05506 0.0571%

人工智慧實際上是如何運作的(只是猜測下一個單字)
發布: 2026/11/01 22:00 閱讀: 0
原文作者:Stack Zero
原文來源:https://www.youtube.com/embed/oT6WzDMksgI
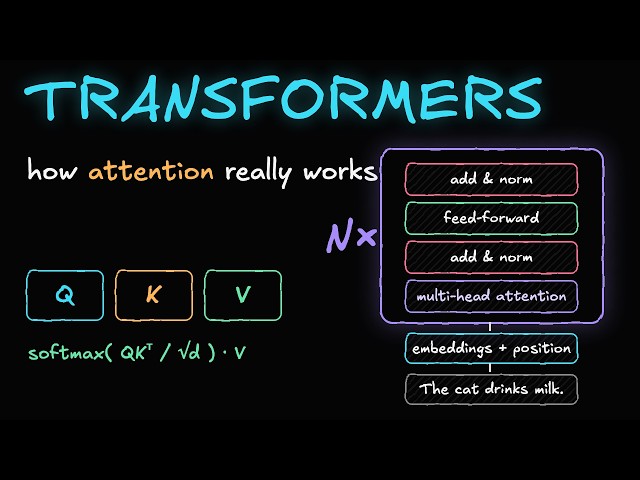
人工智慧實際上是如何運作的? ChatGPT、Claude 或 Gemini 等聊天機器人的每個答案都是由大型語言模型猜測下一個單詞,一次寫入一個標記。這個視覺解釋器遵循整個機器的一個提示。故事始於 1948 年,當時克勞德·香農 (Claude Shannon) 通過翻閱一本書並逐字猜測來造出一個句子。它幾乎成功了,然後崩潰了。今天的目標是一樣的,但機器可以回顧它所讀過的所有內容。我們遵循「第一個在月球上行走的人是…」從標記到向量,通過注意力和 96 層,到機率列表和被選中的一個單字。然後我們研究訓練,為什麼模型在錯誤時聽起來很有自信,以及預測可以走多遠。在該影片中: • 什麼是大型語言模型 (LLM),以及什麼是「參數」 • 標記:如何將文字切成碎片並轉換為數字 • 向量和字詞嵌入(Bengio,2003) • 注意力:查詢、鍵和值,直觀解釋(Vaswani 等人,2017) • Softmax、機率和溫度:如何選擇微觀標記(Vaswani 等人,2017) • Softmax、機率和溫度:如何選擇一個記憶點和章節下一個單字預測模型如何實際產生文字。查看機率語言模型和注意力背後的邏輯。大多數人認為人工智慧模型像人類一樣思考,但它們實際上是統計引擎。本影片詳細介紹了下一個單字預測模型如何根據訓練資料計算下一個標記的機率的機制。我們探索克勞德·香農 (Claude Shannon) 的原始實驗以及它們如何演變成為現代系統提供動力的架構。除了簡單的機率之外,我們還研究了詞向量和注意力機制,以展示機器如何處理上下文。您將了解為什麼這些系統有時會產生無意義的輸出,以及它們如何將語言映射到數學空間。對於任何使用或研究大型語言模型的人來說,理解這些核心原則是至關重要的。堆疊零。複雜的系統。清晰的解釋。真正的影響。訂閱現代軟體背後的技術的每週細分。 0:00 1948 年的猜測單字實驗 0:40 今天的聊天機器人:仍在猜測下一個單字 1:41 什麼是大型語言模型 2:02 令牌和預測循環 2:41 為什麼香農的句子會崩潰 2:56 單字向量的人類猜測遊戲 (1951) 3:32 計數:ngram 到 1947:1995:00 結束(2014) 4:41 變形金剛:「注意力就是你所需要的」(2017) 5:07 模型內部:一個提示,一步一步 5:15 第 1 步:令牌 5:38 第 2 步:向量 6:01 第 3 步:注意力(查詢、鍵、值)步驟:機率與 softmax 7:48 第 5 步:選擇下一個標記(貪婪、採樣、溫度) 8:14 循環:一次一個標記 8:33 訓練:規模化的香農博弈 9:16 從預測器到助手 9:34 一個循環,許多產品 9:455 為什麼預測能走多遠?除非顯示來源,否則螢幕上的數字僅供參考。資料來源 • Shannon (1948),《溝通的數學理論》:https://people.csail.mit.edu/dmoshkov/courses/codes/shannon1948.pdf • Shannon (1951),《印刷英文的預測與熵》: https://sites.socsci.uci.edu/annonrfd/c面面/30,3000 月35-3005 月.等人。 (2003),神經機率語言模型:https://www.jmlr.org/papers/v3/bengio03a.html • Bahdanau、Cho 和 Bengio (2014),共同學習對齊和翻譯的神經機器翻譯:https://arxiv.org/abs/1409.0473 • Vaswani 等人。 (2017),注意力就是你所需要的:https://arxiv.org/abs/1706.03762 • Brown 等人。 (2020),語言模型是少樣本學習者 (GPT-3):https://arxiv.org/abs/2005.14165 • Meta (2024),Meta Llama 3 簡介:https://ai.meta.com/blog/meta-llama-3/ • OpenAI 幫助,什麼是代幣和計算如何計算如何計算https://help.openai.com/en/articles/4936856 • Geva 等。 (2021),變壓器前饋層是鍵值記憶體:https://arxiv.org/abs/2012.14913 (2022),訓練語言模型遵循人類回饋的指令:https://arxiv.org/abs/2203.02155 • OpenAI (2025),為什麼語言模型會產生幻覺:https://openai.com/index/why-language-models-hallucinate/ • Olsson 等人。 (2022),上下文學習與歸納頭:https://transformer-circuts.pub/2022/in-context-learning-and-induction-heads/index.html Stack Zero 從頭開始解釋了日常技術背後的系統。 #AI #LLM #HowAIWorks
近期新聞
更多>>-
 kumis patiler
2026-11-23 06:22
-
 Ha Ms
2026-11-23 06:22
-
 CRYPTO_BEN
2026-11-23 06:22
-
 子敬.轮回珠宝
2026-11-23 06:22
-
 CryptoMetric
2026-11-23 06:22
-
 劇翻天 Drama Go
2026-11-22 16:36
-
 CryptoMason
2026-11-22 16:22
-
 Lý Tử Ly
2026-11-22 14:42
-
 Pidoku
2026-11-22 14:15
精選專題
-
- 狗狗幣鯨魚活動
- 透過我們的綜合分析,了解狗狗幣鯨魚活動的最新見解。了解趨勢、模式以及這些鯨魚對狗狗幣市場的影響。隨時了解我們的專家分析,並在您的加密貨幣之旅中保持領先。
-
- 狗狗幣挖礦
- 狗狗幣挖礦是為狗狗幣區塊鏈添加新交易區塊的過程。礦工因其工作而獲得新的狗狗幣獎勵。本主題提供與狗狗幣挖礦相關的文章,包括如何挖礦狗狗幣、最好的挖礦硬體和軟體以及狗狗幣挖礦的獲利能力。
-
- SpaceX 星艦發射
- 本主題提供與 SpaceX 星艦發射相關的文章,包括發射日期、任務詳細資訊和發射狀態。透過此資訊豐富且全面的資源,了解最新的 SpaceX 星際飛船發射情況。
-
- 迷因之王:狗狗幣
- 本主題提供與最受歡迎的迷因相關的文章,包括「迷因之王:狗狗幣」。 Memecoin 已成為加密貨幣領域的主導者。這些數位資產之所以受歡迎有許多原因。他們推動了區塊鏈最具創新性的方面。
精選文章
更多>>- 1 北極Pablo硬幣(APC):揭開地球的奧秘,一次預售
- 2 Dogecoin,Pepe和Shiba Inu的新高點在2025年,但這個加密貨幣可能會以10,000%的收益偷走該節目
- 3 唐納德·特朗普總統宣布加密戰略儲備後,梅米硬幣的道路起義(DUP)可以100倍
- 4 Dogecoin(Doge)價格預測:到2025年底,Meme硬幣可以達到10美元嗎?
- 5 卡達諾(Cardano)的查爾斯·霍斯金森(Charles Hoskinson)對比特幣和狗狗幣發表了一些著名的評論
- 6 雲挖掘熱潮:比特幣,狗狗和對被動加密收入的追求
- 7 Grayscale、Dogecoin 和 ETF 首次亮相:Meme 幣的新時代?
- 8 Rexas Finance(RXS)到2025年可能會激增10倍,超過Pepe(Pepe)
- 9 比特幣交易員在Doge上賺了3000萬美元,預測這筆0.0000002 AI代幣的激增6,000% - 獲得80%的獎金令牌
- 10 Dogecoin(Doge)價格預測:Meme Coin可能會升至0.27美元
選擇貨幣

US Dollar
USD

Chinese Yuan
CNY

Japanese Yen
JPY
South Korean Won
KRW

New Taiwan Dollar
TWD

Canadian Dollar
CAD

Euro
EUR

Pound Sterling
GBP

Danish Krone
DKK

Hong Kong Dollar
HKD

Australian Dollar
AUD

Brazilian Real
BRL

Swiss Franc
CHF

Chilean Peso
CLP

Czech Koruna KČ
CZK

Singapore Dollar
SGD
Indian Rupee
INR
Saudi Riyal
SAR
Vietnamese Dong
VND

Thai Baht
THB
選擇貨幣
-
US Dollar
USD-$

-
Chinese Yuan
CNY-¥
-
Japanese Yen
JPY-¥
-
South Korean Won
KRW -₩
-
New Taiwan Dollar
TWD-NT$
-
Canadian Dollar
CAD-$
-
Euro
EUR - €
-
Pound Sterling
GBP-£
-
Danish Krone
DKK-KR
-
Hong Kong Dollar
HKD- $
-
Australian Dollar
AUD-$
-
Brazilian Real
BRL -R$
-
Swiss Franc
CHF -FR
-
Chilean Peso
CLP-$
-
Czech Koruna KČ
CZK -KČ
-
Singapore Dollar
SGD-S$
-
Indian Rupee
INR -₹
-
Saudi Riyal
SAR -SAR
-
Vietnamese Dong
VND-₫
-
Thai Baht
THB -฿